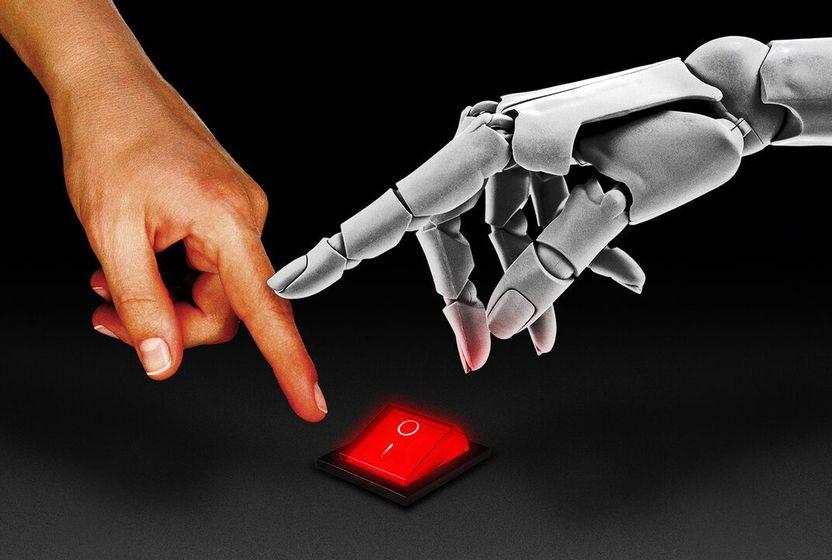
Bir yapay zeka çıkmazı: Telif hakkı için hak arayışı


 Quando
Her salı ve cuma girişimcilik ve teknoloji ekosistemlerinden öne çıkan gelişmeler, paradigma değişimleri, inovasyon trendleri ve dijital dönüşüm e-posta kutunda.
2024 yılının öne çıkan teknolojisi olacağını ise şimdiden garantileyen yapay zeka, hayatımızın pek çok alanında pratik bir asistan işlevi görüyor. Yeri geldiğinde bir arkadaş gibi danışıp fikrini aldığımız bu teknoloji, yeri geldiğinde de kafamıza takılan soruların cevabı oluyor. Tabii, tüm bunlar için yapay zeka dediğimiz şeyin de tıpkı bir insan zekası gibi "eğitilmesi" gerekiyor.
Herhangi bir yapay zeka modelinin kullanıcıların verdiği girdilere, sorduğu sorulara göre karar verip çıkarım yapabilmesi ya da neyin yanlış neyin doğru olduğu sonucuna varabilmesi için sistemin verileri algılamayı, yorumlamayı ve öğrenmeyi öğrenmesi gerekiyor. Bu da iyi tasarlanmış bir yapay zeka modeli, güçlü bir bilgi işlem platformu ve büyük, çok büyük miktarda yüksek kaliteli ve doğru verinin biraraya gelmesiyle mümkün hâle geliyor.
- Yapay zeka eğitimi teknik açıdan oldukça zor bir süreçtir ve genellikle yıllar alır, ancak bir model ne kadar çok, kaliteli ve doğru bilgi ile beslenirse sonuçlar da o kadar isabetli olur.
Ancak, bu eğitimin oldukça tartışmalı bir yanı da bulunuyor: Telif hakkı.
Üretken yapay zeka geliştirmede veri toplama süreci oldukça önemli bir nokta olarak öne çıkıyor. Yapay zeka sistemlerinin eğitiminde bu verilerin elde edildiği yöntemler ve kaynaklar, özellikle de söz konusu telif hakkıyla korunan materyaller olduğunda, çok büyük yasal ve etik sonuçlara sahip olabiliyor.
OpenAI’ın ChatGPT’sinin temelini oluşturan büyük dil modeli GPT gibi modeller, çeşitli çevrimiçi kaynaklardan toplanan geniş veri kümeleri üzerinden eğitilmekte. Bu kaynaklar Wikipedia ve Reddit gibi halka açık web siteleri olabildiği gibi telif hakkıyla korunan materyallerin kolayca erişilebildiği platformlar gibi daha tartışmalı veri depoları da olabilir. Eğitim yalnızca basit veri kazıma işlemlerini değil, aynı zamanda bağlam, stil ve içerik nüanslarını anlamak için karmaşık süreçleri de içerir.
Bu noktada verilerin kamuya açık olsalar bile net olmayan kullanım haklarına sahip olması bazı yasal belirsizlikleri de beraberinde getirmekte. Mesela, kamuya açık bir forumda bulunan bir içeriğin yapay zeka eğitimde kullanılmasının yasak olduğuna ilişkin herhangi bir ibare olmadığı gibi yasak olmadığına dair bir ibare de olmayabilir. Böylesine gri bir alanın varlığı da sanatçıların ve yazarların eserlerinin izinleri veya haberleri olmaksızın yapay zeka eğitim setlerine dahil edilmesiyle, dolayısıyla da fikri mülkiyet haklarının ihlali ile sonuçlanabilir ki son zamanlarda artan davalar da bunun canlı kanlı göstergesi niteliğinde.
Son birkaç aydır pek çok yazar, sanatçı ve medya holdingi, eserlerinin yapay zeka eğitiminde kullanılması karşılığında taraflarına tazminat ödenmesi talebiyle atağa geçmiş durumda. Telif hakkıyla korunan içeriğin yapay zeka şirketleri tarafından kontrolsüz kullanımına karşı artan bir direncin simgesi niteliğinde olan bu atak, üretken yapay zeka modellerinin eğitildikleri orijinal eserlerden türettikleri içerikler ile sanatçılara, yazarlara ve kuruluşlara maddi ve manevi zarar verebilme potansiyeline de dikkat çekiyor.
- Bilgi notu: Kısa süre önce yapay zeka ile üretilen kitaplar Amazon’un en çok satanlar listesinde yer almıştı.
Giderek kabaran liste
Aralarında Margaret Atwood, Dan Brown ve Jodi Picoult gibi isimlerin de bulunduğu 8 bin 500'i aşkın Yazarlar Birliği üyesi Temmuz ayında bir açık mektup yayımlandı. OpenAI, Google ve Microsoft gibi yapay zeka devlerine seslenen mektupta, ChatGPT ve Bard gibi üretken yapay zeka uygulamalarının eğitiminde edebi eserlerin izinsiz kullanımının durdurulması için çağrıda bulunuluyor; yazarlar, yapay zeka sistemlerini beslemek için toplanan verileri için tazminat talep ediyordu.
Üç gün önce ise Nicholas A. Basbanes ve Nicholas Gage isimli iki yazar, OpenAI ve en büyük destekçisi konumundaki Microsoft’u, GPT büyük dil modellerini (LLM) eğitmek için telif hakkı ile korunan eserlerini izinsiz bir şekilde kullandıkları gerekçesiyle dava etti. Profesyonel yazarların araştırmalarını finanse etmek için sınırlı sermayeye sahip olduklarını ve projelerini genellikle kendi kendilerine finanse ettiklerini, buna karşılık yapay zeka şirketlerinin ise milyarlarca dolarlık sermayeye sahip olduğu belirten yazarlar; telifli eserleri kullanmanın “kasıtlı bir strateji” olduğunu ve eser sahiplerine ödeme yapmamanın “daha yüksek kâr marjı” sağladığını ifade etti.
Basbanes ve Gage’e göre yapay zeka şirketleri, kâr paylaşımı gibi alternatif finansman seçeneklerini değerlendirmek yerine “çalmayı” tercih ediyor. İkili, ihlal edilen eser başına 150 bin dolara kadar tazminat ve zararın tekrarlanmasını önlemek için kalıcı tedbir kararı talep ediyor.
Öte yandan, bu dava, OpenAI’a açılan ilk telif davası değil. Zaten OpenAI da telif nedeniyle davalık olan ilk ve tek yapay zeka şirketi değil. Aslına bakarsanız, telif hakkı ihlali iddiasıyla dava açılan yapay zeka şirketleri listesinin bir hayli uzun:
- Temmuz ayında yazar Mona Awad ve Paul Tremblay, ChatGPT’nin telif hakkıyla korunan eserleri üzerinden eğitildiğini iddia ederek OpenAI’ya dava açmış; aynı ay açılan bir diğer davada ise yazar Christopher Golden ve Richard Kadrey ile komedyen Sarah Silvermen eserlerinin OpenAI ve Meta tarafından izinsiz bir şekilde kullanıldığını öne sürmüştü.
- Eylül ayında da hem aralarında Jonathan Franze, John Grisham ve Buz ve Ateşin Şarkısı serisinin yazarı George R.R. Martin’in de bulunduğu 17 yazar ile Yazarlar Birliği hem de yazarlar Michael Chabon, David Henry Hwang, Rachel Louise Snyder ve Ayelet Waldman tarafından açılan iki toplu davada OpenAI, telif hakkıyla korunan içerikleri "izinsiz ve yasadışı” bir şekilde kullanmakla suçlanmıştı.
- Bir diğer toplu dava ise GitHub, Microsoft ve OpenAI’ın kod yazma sürecini kolaylaştırmak amacıyla geliştirdiği GitHub Copilot’ı hedef alıyor. Kasım 2022’de açılan davada davacılar, Copilot'un GitHub'ın depolarındaki kodu hukuka aykırı bir şekilde yeniden ürettiğini ve uygun atıfta bulunmamak da dahil olmak üzere lisanslama gerekliliklerini göz ardı ettiğini savunuyor. Dahası, bu dava, telif hakkı şikayetlerinin de ötesinde GitHub’ı kişisel verilerin kötüye kullanımı ve dolandırıcılıkla suçluyor.
- Aralık 2023’te de The New York Times hem OpenAI hem de Microsoft’u, dil modellerini eğitmek için çatısı altında yayımlanan milyonlarca makaleyi kullandığını öne sürerek dava etti. ChatGPT'nin abonelik gerektiren makalelerinden "kelimesi kelimesine alıntılar" yapabildiğini belirten New York Times, OpenAI'ın "milyarlarca dolarlık" zarardan sorumlu tutulması gerektiğini ifade ediyor.
- Yapay zeka devlerinden Google da telif hakkı davalarından nasibini alanlardan: Temmuz 2023’te açılan toplu davada Google, Bard’ı eğitmek için arkadaşlık sitelerinden görseller, TikTok’tan videolar ve Spotify’dan çalma listeleri gibi veriler toplamakla suçlanıyor. Mahremiyet ve mülkiyet haklarına dikkat çeken davada Google’ın 5 milyar doları aşan zarardan sorumlu olabileceği değerlendiriliyor.
- Bununla birlikte, telif hakkı ve yapay zeka çevresinde dönen davaların hepsi yazılı eserleri ilgilendirmiyor. Ocak 2023’te açılan bir davada davacılar; Stability AI, Midjourney ve DeviantArt’ın metin girdisinden görsel üreten yapay zeka modellerini eserleri üzerinden eğittiğini ve eserlerinin türevlerini ürettiğini iddia etmişti. Getty Images ise haklarına sahip olduğu sayısız görüntü ve ilgili meta verileri izinsiz kopyaladığı ve işlediği gerekçesiyle Stability AI'a iki ayrı dava açmıştı.
Bu davaların hepsinde davacı taraflar, eserlerinin teknoloji devleri tarafından yapay zeka modellerini eğitmek için izinsiz bir şekilde kullanılmasının kendilerine maddi zarar verdiğini ve davalının üzerlerinden haksız kazanç sağladığını vurguluyor. Öte yandan, bu tarz yasal sorunlar yaşamamak için önlemler alan veya almaya çalışan şirketler de yok değil:
- Aralık sonunda The New York Times’ın bildirdiği üzere Apple, geliştirmekte olduğu üretken yapay zeka sistemlerinin eğitiminde kullanmak üzere haber arşivlerini lisanslamak için Conde Nast, NBC News ve IAC gibi yayınlarla görüşmeler yapıyor. Buna göre, şirketin anlaşmalar için en az 50 milyon doları gözden çıkardığı belirtiliyor.
- Modellerinin eğitiminde medya kuruluşlarının kaynaklarından yararlanmak için anlaşmalar yapan bir diğer isim ise başı hâlihazırda telif davalarıyla dertte olan OpenAI. OpenAI’ın modellerinin eğitimi için Associated Press ve Business Insider ile Politico’nun ana şirketi Axel Springer ile anlaşmalar imzaladığı biliniyor.
Zamana karşı yarış
Öte yandan, yapay zeka inanılması güç bir hızda gelişmeye devam ediyor. Yapay zeka araştırmacısı Gary Marcus ve dijital sanatçı Reid Southen tarafından yürütülen yeni bir araştırma ise yapay zeka modellerinin basit bir metin komutuyla "ticari markalı karakterlerin neredeyse kopyalarını" üretebildiğini ortaya koyuyor.
Araştırmaya göre, OpenAI’ın DALL-E 3’üne “video oyunu italyan” komutu verildiğinde Super Mario’nun görüntülerine; “animasyon sünger” komutu verildiğinde ise SüngerBob karakterinin görüntülerine ulaşılabiliyor. Marcus ve Southen, aynı deneyi Midjourney üzerinde yürüttüklerinde de benzer sonuçlar elde ettiklerini aktarıyor. Buna göre, Midjourney, "90'ların sarı tenli popüler çizgi filmi" komutu verildiğinde "The Simpsons" karakterlerinin görüntülerin; "hafif kılıçlı siyah zırh" komutu verildiğinde ise Star Wars serisindeki karakterlere yakın bir benzerlikte görüntüler üretebiliyor.
Evet, DALL-E 3 yalnızca iki kelimelik komutlarla ticari marka altındaki eserleri “üretebiliyor”.
Şu an devam etmekte olan davaların hepsi ilk aşamalarda ve anlaşma olmaması hâlinde bu davalar yıllarca sürebilir; ancak her koşulda, davaların mahkemeye taşınmış olması, yapay zeka şirketlerinin telifli verileri nasıl kullanabileceği gibi önemli soruların yanıtlanması için doğru yolda olunduğuna işaret ediyor.
Her koşulda, uzmanlara göre telif hakkının, üretken yapay zeka endüstrisini şekillendirecek kilit noktalardan biri olacağı değerlendiriliyor. Ancak, sektörün keskin hatlarla çizilmiş net cevaplar almasının da biraz zaman alabileceğine kesin gözüyle bakılıyor. Tabii, dünya genelinde henüz büyük ölçüde regüle edilememiş yapay zeka endüstrisinin belli kurallar çerçevesine oturtulması gerekiyor ki bu konunun nasıl bir yolda ilerleyeceğine dair 2024 yılında daha sağlam bir fikre sahip olmaya başlayacağız gibi görünüyor.


Kaydet

Okuma listesine ekle
Paylaş
QuandoHer salı ve cuma girişimcilik ve teknoloji ekosistemlerinden öne çıkan gelişmeler, paradigma değişimleri, inovasyon trendleri ve dijital dönüşüm e-posta kutunda.
İLGİLİ BAŞLIKLAR
NEREDE YAYIMLANDI?
WordPad'e veda. Vision Pro için tarih. Dünyanın ilk yeraltı otonom robot teslimat sistemi. Bard'ın ücretli sürümü. OpenAI'ın The New York Times'a cevabı. Yapay zeka eğitiminde telif hakkı arayışı.
09 Oca 2024

YAZARLAR

İrem Denli
Teknoloji Editörü
Quando
Her salı ve cuma girişimcilik ve teknoloji ekosistemlerinden öne çıkan gelişmeler, paradigma değişimleri, inovasyon trendleri ve dijital dönüşüm e-posta kutunda.
İLGİLİ OKUMALAR
Algoritmalar artık iş dağıtıyor, çalışanları puanlıyor ve hatta işten çıkarma kararlarında belirleyici oluyor; insan denetimi ise otomasyon yanlılığı ve gig ekonomisinin hukuki boşlukları nedeniyle her zaman gerçek bir güvence sağlamıyor. Kaliforniya, “Robot Patrona Hayır” yasası ile işten çıkarma ve disiplin kararlarının yalnızca yapay zekaya bırakılmasını yasaklayan ilk ABD eyaleti oldu belki ama asıl sorunun kapitalizmin ulaştığı noktayla ilgili olduğunu hatırlamak gerekiyor.
Şirketler yapay zekayı toplantı notu çıkaran araçlardan operasyon yürüten ajanlara dönüştürmek istiyor; ancak bir yandan da güvenilmez veri, eksik bağlam ve belirsiz sorumluluklar kurumların yıllardır kapalı odalarda tuttuğu dağınıklığı da su yüzüne çıkarıyor. Üstelik ajanların gerçekten işe yaradığı bir düzende asıl mesele, onlara hangi işleri devredeceğimiz kadar açılan zamanı insanın muhakemesine, öğrenmesine ve daha nitelikli üretime ayırıp ayıramayacağımız da.
Yıllarca makineleri insanların anlayabileceği biçimde tasarlamaya çalıştık. Yapay zeka bu problemi çözüyor gibi görünüyor ama önümüze daha tuhaf bir tasarım sorusu çıkarıyor: İnsanların kendilerini makinelerin anlayacağı biçimde yeniden düzenlemeye başladığını nasıl fark edeceğiz ve hangi noktada bunu gerçekten problem sayacağız?
Birkaç yıl önce bir ürünün ismine “yapay zeka destekli” ifadesini eklemek, onu bir anda daha yeni, daha akıllı ve daha değerli gösterirdi. Bugün ise bu ifade, hemen hemen her üründe rastlanan son derece sıradan ve hatta kimi zaman “korkutucu” bir etiket hâline geldi. Güvenlik endişeleri, şirketleri ürünlerini “sevimli dijital maskotlar” arkasına gizlemeye iterken ABD hükümeti, çözümü yapay zekanın adını “süper zeka” olarak değiştirmekte buldu.
Bir sohbet robotunun hayatımızı kolaylaştırması, onu geliştiren şirketlerin gelecek planlarına onay verdiğimiz anlamına mı geliyor? Yapay zeka, insanın yerini almak için mi, yoksa insanın kapasitesini genişletmek için mi geliştiriliyor? Nobel ödüllü ekonomist Daron Acemoğlu’nun son dönemdeki açıklamaları bu sorulara odaklanıyor.